项目概述
Agent Reliability Lab 展示了一种智能体软件边界:语言模型可以理解请求并提出工具调用,但是否有效、是否受限以及是否安全执行,应由确定性的应用程序代码决定。这是一个基于合成电商数据的独立工程演示,并非客户项目或生产电商系统。
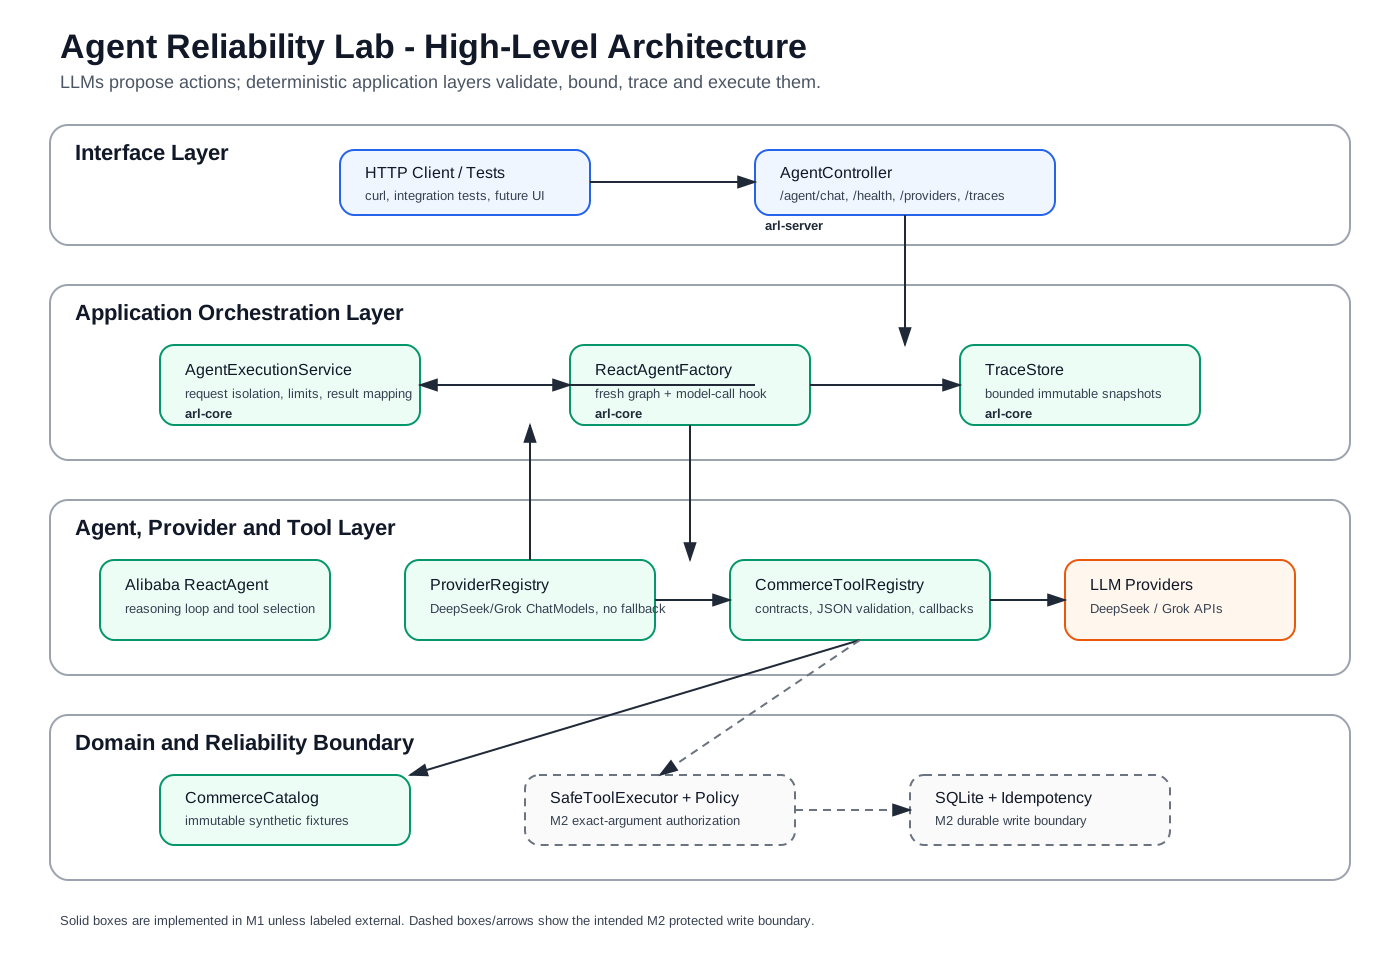
系统使用 Alibaba ReactAgent 处理推理流程,并通过 Spring AI 的 OpenAI 兼容适配器连接 DeepSeek 和 Grok。模型可以查看商品、库存和订单。库存预留走独立的受保护路径:智能体可以提出请求,但应用程序必须在提交库存变更前验证确认令牌和幂等键。
工程挑战
智能体可能生成格式错误的参数、提出未知工具、在操作未成功时声称成功,或重复执行操作。若将生成文本视为业务事实,这些情况就难以控制。这里的工程目标更为明确且可测试:由应用程序代码负责工具契约和状态变更,并确保可观察结果能够追溯到经过验证的工具结果。
架构
Spring 服务提供聊天、确认、服务商状态、健康检查和追踪端点。编排服务显式选择服务商并创建请求级智能体。注册的工具回调负责验证参数,并操作确定性的领域状态。SQLite 保存合成商品目录、预留和幂等状态;追踪以有限容量保存在内存中。独立评估模块运行脚本化场景。React 演示界面调用 API,不负责授权或变更决策。
关键设计决策
- 由应用程序代码管理工具契约。严格验证参数、执行业务约束并生成工具结果;模型只能选择工具,不能授权写入。
- 受保护的写入需要单独的确认请求。提出请求本身不会改变库存。演示确认流程并非绑定身份的生产授权。
- 不自动切换服务商。服务商选择与凭据错误会明确呈现,不会静默路由到其他服务商。
- 评估将应用契约与模型质量区分开来。离线测试使用脚本模型,不调用付费 API;测试结果描述应用行为,不代表模型自主能力。
实现与验证
项目将可复用的智能体与领域逻辑(arl-core)、Spring HTTP 组合层(arl-server)和离线评估(arl-evaluation)分开。文档说明了模型调用与工具提案的边界、错误信息清理、不可变的服务商配置,以及模型调用和工具执行的追踪事件。前端提供服务商状态、聊天、受保护确认和追踪查看功能。
README 记录了覆盖 10 类可靠性问题的 59 个确定性离线场景。测试涉及工具行为、API 路径、持久化恢复、服务商配置和评估。所检查主分支提交对应的 GitHub Actions 质量工作流最近一次可见运行已成功。这是仓库工作流的证据,并非本网站刚刚执行的本地构建结果。
局限与后续工作
这是一个本地合成电商实验项目,不包含身份验证、持久化审计记录、绑定身份的授权或生产部署配置。确认流程展示了提案与执行的分离,但并非生产级人工审批系统。脚本化测试无法验证实时模型质量或服务商可用性。生产设计还需根据领域增加适当的身份、授权、持久化审计和运维控制。
项目资源
验证说明
- 所检查主分支提交对应的 GitHub Actions 质量工作流最近一次可见运行已成功。
- README 记录了 10 类可靠性场景中的 59 个确定性离线测试,包括受保护写入、幂等性、恢复和追踪完整性。
- 单元测试和 API 测试覆盖工具验证、确认、服务商行为与追踪;项目文档将 make verify 列为本地验收命令。
局限
- 使用本地合成电商数据,并非生产电商服务。
- 不包含身份验证或绑定身份的授权。追踪数据仅在内存中有限保存,不是持久化审计记录。
- 基于脚本模型的离线评估不能证明实时服务商的准确性、质量或可用性。